Ein Zuverlässigkeitsingenieur möchte die Zuverlässigkeit eines neuen Auspufftyps bewerten und den Anteil der Garantieansprüche schätzen, der mit einer 50.000-Meilen-Garantie zu erwarten ist. Der Techniker erfasst Ausfalldaten sowohl für den alten als auch für den neuen Typ von Schalldämpfern. Die Schalldämpfer wurden alle 10.000 Meilen auf einen Ausfall geprüft.
Der Lokführer erfasst die Anzahl der Ausfälle für jeden 10.000-Meilen-Intervall. Daher werden die Daten intervallzensiert. Bevor die Ausfalldaten für die neuen Schalldämpfer mit Verteilungsgebundene Analyse analysiert werden, wählt Verteilungsidentifikation der Ingenieur ein Verteilungsmodell für die Analyse aus.
- Öffnen Sie die Beispieldaten Schalldämpferzuverlässigkeit.MWX.
- Wählen Sie aus.
- Wählen Sie im Feld Zensierung die Option Intervallzensierte Daten aus.
- Wählen Sie im Feld Daten die Option Eine oder mehrere Stichproben, jeweils in separaten Start- und Endspalten aus.
- Geben Sie im Feld Startspalte die Spalte StartNeu ein.
- Geben Sie im Feld Endspalte die Spalte EndeNeu ein.
- Geben Sie im Feld Häufigkeitenspalte (optional) die Spalte HäufNeu ein.
-
Abwählen Lage-Skala-Verteilungen und Verteilungen mit einem Schwellenwertparameter die folgenden Verteilungen bewerten:
- Weibull
- Lognormal
- Loglogistisch
- Exponential
- Wählen Sie OK aus.
Interpretieren der Ergebnisse
Im Weibull-Wahrscheinlichkeitsdiagramm liegen die Punkte ungefähr auf der geraden Linie. Daher bietet die Weibull-Verteilung eine gute Anpassung. Der Ingenieur entscheidet sich daher, die Weibull-Verteilung zur Modellierung der Daten zu Verteilungsgebundene Analyse verwenden.
Minitab zeigt außerdem eine Tabelle der Perzentile und eine Tabelle der mittleren Ausfallzeit (MTTF) an, die berechnete Ausfallzeiten für jede Verteilung bereitstellen. Sie können die berechneten Werte vergleichen, um zu sehen, wie sich Ihre Schlussfolgerungen mit unterschiedlichen Verteilungen ändern könnten. Wenn mehrere Verteilungen gut zu Ihren Daten passen, möchten Sie vielleicht die Verteilung verwenden, die die konservativsten Ergebnisse liefert.
Tipp
Die Analyse speichert eine Zuverlässigkeitsdatendefinition, die die Stichprobenspalten und das Zensurschema umfasst. Wählen Sie die Definition aus, um schnell Verteilungsfreie Analyse, Verteilungsidentifikation, Verteilungsgebundene Analyse, und Verteilungsübersicht auf denselben Daten auszuführen.
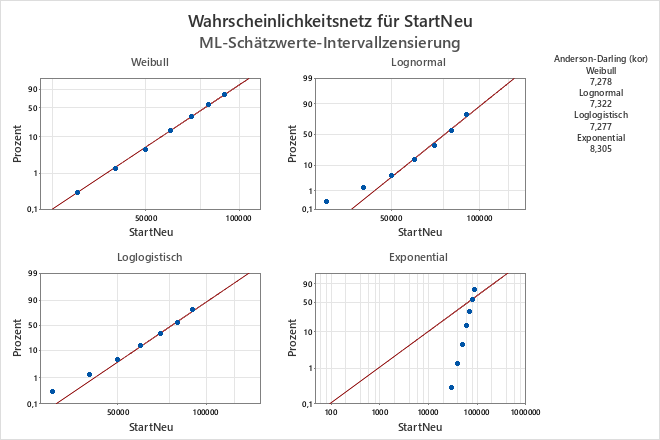
Güte der Anpassung
| Verteilung | Anderson-Darling (kor) |
|---|---|
| Weibull | 7,278 |
| Lognormal | 7,322 |
| Loglogistisch | 7,277 |
| Exponential | 8,305 |
Perzentiltabelle
| Normales 95%-KI | |||||
|---|---|---|---|---|---|
| Verteilung | Prozent | Perzentil | Standardfehler | Untergrenze | Obergrenze |
| Weibull | 1 | 37265,1 | 938,485 | 35470,3 | 39150,6 |
| Lognormal | 1 | 43817,7 | 688,033 | 42489,7 | 45187,2 |
| Loglogistisch | 1 | 41843,3 | 810,048 | 40285,4 | 43461,5 |
| Exponential | 1 | 941,789 | 32,5296 | 880,143 | 1007,75 |
| Weibull | 5 | 49434,9 | 841,147 | 47813,5 | 51111,3 |
| Lognormal | 5 | 51458,9 | 624,451 | 50249,5 | 52697,5 |
| Loglogistisch | 5 | 51967,9 | 703,264 | 50607,7 | 53364,8 |
| Exponential | 5 | 4806,55 | 166,019 | 4491,93 | 5143,21 |
| Weibull | 10 | 56006,1 | 759,186 | 54537,7 | 57514,0 |
| Lognormal | 10 | 56063,1 | 585,905 | 54926,4 | 57223,3 |
| Loglogistisch | 10 | 57323,9 | 638,684 | 56085,7 | 58589,5 |
| Exponential | 10 | 9873,05 | 341,017 | 9226,79 | 10564,6 |
| Weibull | 50 | 77639,9 | 501,312 | 76663,5 | 78628,7 |
| Lognormal | 50 | 75850,3 | 576,625 | 74728,5 | 76988,9 |
| Loglogistisch | 50 | 76490,1 | 545,549 | 75428,3 | 77566,9 |
| Exponential | 50 | 64952,9 | 2243,49 | 60701,3 | 69502,3 |
Tabelle für MTTF
| Normales 95%-KI | ||||
|---|---|---|---|---|
| Verteilung | Mittelwert | Standardfehler | Untergrenze | Obergrenze |
| Weibull | 76585,0 | 488,71 | 75633,1 | 77549 |
| Lognormal | 77989,9 | 615,96 | 76792,0 | 79207 |
| Loglogistisch | 78702,3 | 579,02 | 77575,6 | 79845 |
| Exponential | 93707,3 | 3236,67 | 87573,5 | 100271 |
