某可靠性工程师想研究涡轮装置中发动机绕组的失效率以确定绕组失效的时间。在高温下,绕组可能会分解过快。
工程师记录发动机绕组在不同温度下的故障时间。然而,有些单元在考试结束前并未失败。因此,数据为右删失数据。为了选择80°C数据的分布模型,工程师使用 分布 ID 图。
- 打开样本数据 发动机绕组可靠性.MWX。
- 选择 。
- 从删失 中,选择右删失数据,带有删失列。
- 从数据 中,选择一个或多个样本,每列一个。
- 在 样本列中,输入80 度。
- 在 删失列中,输入80 度删失。
- 在中删失值,选择 0。
-
取消选择 位置尺度分布 并 带有阈值参数的分布 评估以下分布:
- Weibull
- 对数正态
- 对数 Logistic
- 指数
- 选择 确定。
解释结果
失效时间的点大致落在对数归一概率图的直线上。因此,对数正态分布提供了良好的拟合。因此,工程师决定使用对数正态分布来建模在80°C下收集的数据。
Minitab 还显示百分位表和平均失效时间(MTTF)表,提供每个分布的计算失效时间。你可以比较计算出的数值,看看不同分布下你的结论可能有何变化。如果多个分布都适合你的数据,你可能想使用结果最保守的分布。
提示
分析存储包含样本列和审查方案的可靠性数据定义。选择定义以快速运行 分布 ID 图、 分布概要图、 参数分布分析和 非参数分布分析 在同一数据上。
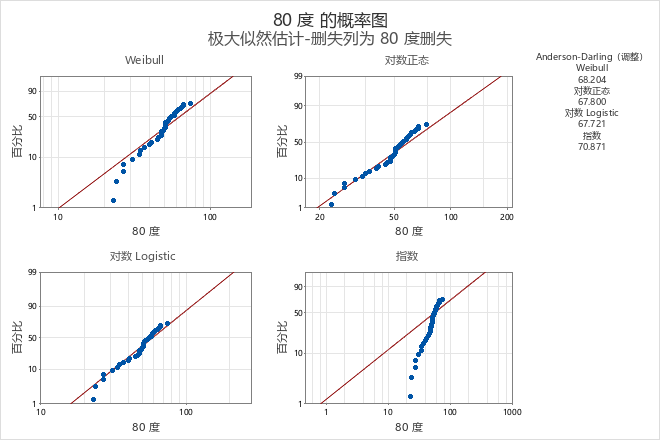
拟合优度
| 分布 | Anderson-Darling (调整) |
|---|---|
| Weibull | 68.204 |
| 对数正态 | 67.800 |
| 对数 Logistic | 67.721 |
| 指数 | 70.871 |
百分位数表格
| 95% 正态置信区间 | |||||
|---|---|---|---|---|---|
| 分布 | 百分比 | 百分位数 | 标准误 | 下限 | 上限 |
| Weibull | 1 | 10.0765 | 2.78453 | 5.86263 | 17.3193 |
| 对数正态 | 1 | 19.3281 | 2.83750 | 14.4953 | 25.7722 |
| 对数 Logistic | 1 | 16.0857 | 2.99498 | 11.1675 | 23.1699 |
| 指数 | 1 | 0.809731 | 0.133119 | 0.586684 | 1.11758 |
| Weibull | 5 | 20.3592 | 3.79130 | 14.1335 | 29.3273 |
| 对数正态 | 5 | 26.9212 | 3.02621 | 21.5978 | 33.5566 |
| 对数 Logistic | 5 | 25.5948 | 3.27675 | 19.9149 | 32.8947 |
| 指数 | 5 | 4.13258 | 0.679391 | 2.99422 | 5.70371 |
| Weibull | 10 | 27.7750 | 4.11994 | 20.7680 | 37.1463 |
| 对数正态 | 10 | 32.1225 | 3.09409 | 26.5962 | 38.7970 |
| 对数 Logistic | 10 | 31.5836 | 3.29780 | 25.7385 | 38.7560 |
| 指数 | 10 | 8.48864 | 1.39552 | 6.15037 | 11.7159 |
| Weibull | 50 | 62.6158 | 4.62515 | 54.1763 | 72.3700 |
| 对数正态 | 50 | 59.8995 | 4.31085 | 52.0192 | 68.9735 |
| 对数 Logistic | 50 | 58.6087 | 4.07051 | 51.1498 | 67.1552 |
| 指数 | 50 | 55.8452 | 9.18089 | 40.4622 | 77.0766 |
平均故障时间间隔表格
| 95% 正态置信区间 | ||||
|---|---|---|---|---|
| 分布 | 均值 | 标准误 | 下限 | 上限 |
| Weibull | 64.9829 | 4.6102 | 56.5472 | 74.677 |
| 对数正态 | 67.4153 | 5.5525 | 57.3656 | 79.225 |
| 对数 Logistic | 66.9996 | 5.5835 | 56.9031 | 78.887 |
| 指数 | 80.5676 | 13.2452 | 58.3746 | 111.198 |
