このトピックの内容
ステップ1:応答に対して最大の効果を持つ項を特定する
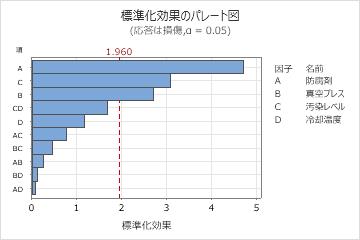
標準化効果のパレート図を使用すると、主効果および交互作用両方の相対的重要度および統計的有意性を比較することができます。
Minitabでは、標準化効果をその絶対値の降順でプロットします。図上の参照ラインは、どの効果が有意であるかを示します。デフォルトでは、有意水準0.05で参照ラインが引かれます。
主要な結果:パレート図
この結果では、防腐剤の種類(A)、真空封止圧力(B)、汚染度(C)の3つの主効果は統計的に有意です(α = 0.05)。
また、防腐剤の種類(A)は最も長く伸びているため、これが最大の効果を持つこともわかります。冷却温度相互作用(AD)による防腐剤の効果の伸びは最も短いため、効果は最小です。
ステップ2:応答に対して統計的に有意な効果を持つ項を特定する
- p値 ≤ α:関連性は統計的に有意である
- p値が有意水準以下の場合は、応答変数と項の間に統計的に有意な関連性が存在すると結論付けることができます。
- p値 > α:その関連性は統計的に有意ではない
- p値が有意水準より大きい場合は、応答変数と項の間に統計的に有意な関連性があると結論することはできません。項を持たないモデルを再適合したいと考えるかもしれません。
- 因子の係数が有意である場合、事象の確率が全ての因子水準で同じではないと結論付けることができます。
- 共変量の係数が有意な場合は、変数の値の変化が確率の変化と関連付けられています。
- 交互作用項の係数が有意な場合は、因子と応答の間の関係はその項の他の因子に依存します。こうしたケースでは、交互作用の影響の考慮なしに主効果を解釈すべきではありません。
- ブロックの係数が統計的に有意である場合、ブロックのリンク関数は平均値と異なると論付けることができます。
コード化係数
| 項 | 効果 | 係数 | 係数の標準誤差 | VIF |
|---|---|---|---|---|
| 定数 | -2.7370 | 0.0479 | ||
| 防腐剤 | 0.4497 | 0.2249 | 0.0477 | 1.03 |
| 真空プレス | 0.2574 | 0.1287 | 0.0477 | 1.06 |
| 汚染レベル | 0.2954 | 0.1477 | 0.0478 | 1.06 |
| 冷却温度 | -0.1107 | -0.0554 | 0.0478 | 1.07 |
| 防腐剤*真空プレス | -0.0233 | -0.0117 | 0.0473 | 1.05 |
| 防腐剤*汚染レベル | 0.0722 | 0.0361 | 0.0474 | 1.06 |
| 防腐剤*冷却温度 | 0.0067 | 0.0034 | 0.0472 | 1.05 |
| 真空プレス*汚染レベル | -0.0430 | -0.0215 | 0.0469 | 1.04 |
| 真空プレス*冷却温度 | -0.0115 | -0.0058 | 0.0465 | 1.02 |
| 汚染レベル*冷却温度 | 0.1573 | 0.0786 | 0.0467 | 1.02 |
主要な結果:係数
これらの結果では、防腐剤、真空プレス、汚染度の主効果の係数は正の数値です。低温の主効果の係数は負の数値です。一般的に、項の値が増加するにつれ、係数が正の場合は事象の可能性は高くなり、係数が負の場合は事象の可能性は低くなります。
分散分析
| 要因 | 自由度 | 調整偏差 | 調整平均 | カイ二乗 | p値 |
|---|---|---|---|---|---|
| モデル | 10 | 46.2130 | 4.6213 | 46.21 | 0.000 |
| 防腐剤 | 1 | 22.6835 | 22.6835 | 22.68 | 0.000 |
| 真空プレス | 1 | 7.3313 | 7.3313 | 7.33 | 0.007 |
| 汚染レベル | 1 | 9.6209 | 9.6209 | 9.62 | 0.002 |
| 冷却温度 | 1 | 1.3441 | 1.3441 | 1.34 | 0.246 |
| 防腐剤*真空プレス | 1 | 0.0608 | 0.0608 | 0.06 | 0.805 |
| 防腐剤*汚染レベル | 1 | 0.5780 | 0.5780 | 0.58 | 0.447 |
| 防腐剤*冷却温度 | 1 | 0.0051 | 0.0051 | 0.01 | 0.943 |
| 真空プレス*汚染レベル | 1 | 0.2106 | 0.2106 | 0.21 | 0.646 |
| 真空プレス*冷却温度 | 1 | 0.0153 | 0.0153 | 0.02 | 0.902 |
| 汚染レベル*冷却温度 | 1 | 2.8475 | 2.8475 | 2.85 | 0.092 |
| 誤差 | 5 | 0.9674 | 0.1935 | ||
| 合計 | 15 | 47.1804 |
主要な結果:p値
これらの結果では、防腐剤、真空プレス、汚染度に対する主効果は、α = 0.05の有意水準において統計的に有意です。この結果から、これらの変数の変化は応答変数の変化に関連付けられていると結論付けることができます。
交互作用の項は統計的に有意ではありません。各変数と応答の関係は、他の変数の値に依存しない可能性があります。
ステップ3:予測変数の効果を理解する
- 連続予測変数のオッズ比
-
オッズ比が1より大きい場合、予測変数が増加するにつれて事象が発生する可能性が高くなることを示しています。オッズ比が1未満の場合、予測変数が増加するにつれて事象が発生する可能性が低くなることを示しています。
連続予測変数のオッズ比
変更ユニット オッズ比 95%信頼区間 投薬量(mg) 0.5 6.1279 (1.7218, 21.8087) 主要な結果:オッズ比
これらの結果では、モデルは薬の投与水準を使用して、成人の体内のバクテリアの有無を予測します。この例ではバクテリアがないことが事象に該当します。各錠剤に0.5mgの投与量があるので、研究者は0.5mgの単位変化を使用します。オッズ比はおよそ6です。成人が服用する錠剤を追加する度に、患者にバクテリアがないというオッズは約6倍増加します。
- カテゴリ予測変数のオッズ比
-
カテゴリ変数の場合、オッズ比は、予測変数の2つの異なる水準に出現する事象のオッズを比較します。水準Aと水準Bの2つの列に水準を登録することによって比較を設定できます。水準Bは因子の参照水準です。オッズ比が1より大きい場合、事象は水準Aになる可能性が高くなることを示します。オッズ比が1未満の場合、事象は水準Aになる可能性が低くなることを示します。カテゴリ予測変数のコーディングに関する詳細はカテゴリ予測変数のコード化方式を参照してください。
カテゴリ予測変数のオッズ比
水準A 水準B オッズ比 95%信頼区間 月 2 1 1.1250 (0.0600, 21.0834) 3 1 3.3750 (0.2897, 39.3165) 4 1 7.7143 (0.7461, 79.7592) 5 1 2.2500 (0.1107, 45.7172) 6 1 6.0000 (0.5322, 67.6397) 3 2 3.0000 (0.2547, 35.3325) 4 2 6.8571 (0.6556, 71.7169) 5 2 2.0000 (0.0976, 41.0019) 6 2 5.3333 (0.4679, 60.7946) 4 3 2.2857 (0.4103, 12.7323) 5 3 0.6667 (0.0514, 8.6389) 6 3 1.7778 (0.2842, 11.1200) 5 4 0.2917 (0.0252, 3.3719) 6 4 0.7778 (0.1464, 4.1326) 6 5 2.6667 (0.2124, 33.4861) 主要な結果:オッズ比
この結果では、カテゴリ予測変数はホテルの繁忙期の開始月です。応答は、宿泊客が予約をキャンセルするかどうかです。この例ではキャンセルは事象です。最大オッズ比は7.71で、水準Aが4か月目のときと水準Bが1か月目のときが当てはまります。これは、宿泊客が4か月目に予約をキャンセルするオッズは、宿泊客が1か月目に予約をキャンセルするオッズよりも約8倍高いことを示しています。
ステップ4:データに対するモデルの適合度を判断する
注
モデル要約統計量や適合度統計量の多くは、ワークシート内のデータの配置や各行で試行が1回なのか複数回なのかによって影響されます。ホスマー-レメショウ検定は、データの配置に影響されず、行ごとで1回の試行の場合と複数の試行の場合とで比較されます。詳細はデータフォーマットが2値ロジスティック回帰の適合値に与える影響を参照してください。
- 逸脱度R二乗
-
逸脱R2値が大きくなるほど、データへのモデル適合度は上がります。逸脱R2は必ず0~100%の間の値になります。
逸脱度R2はモデルに新しい項を追加すると必ず大きくなります。たとえば、最適な5項モデルのR2は必ず、最適な4項モデルと少なくとも同じ大きさになります。したがって、逸脱度R2値は同じ大きさのモデルの比較に最も便利です。
データの配置は逸脱度R2値に影響します。逸脱度R2は通常、行ごとに試行が1回の場合のデータより複数の試行の場合のデータの方が高くなります。逸脱度R2値は同じデータフォーマットのモデル間でのみ比較可能です。
適合度統計量は、データに対するモデルの適合度を測る1つの測度に過ぎません。モデルの値が望ましい場合でも残差プロットと適合度検定を確認してデータに対するモデルの適合度を評価する必要があります。
- 逸脱度R二乗(調整済み)
-
異なる数の項を持つモデルを比較する場合は、調整済み逸脱度R2を使用します。逸脱度R2はモデルに項を追加すると必ず大きくなります。調整済み逸脱度R2値にはモデルに含まれる項の数が組み入れられるため、正しいモデルの選択に役立ちます。
- AIC、AICc、BIC
-
異なるモデルを比較する際はAIC、AICc、BICを使用します。いずれの統計量でも、小さい値が好ましいと考えられます。ただし、予測変数セットに対して最小値を持つモデルは必ずしもデータに良好に適合しません。適合度検定と残差プロットも使用して、データに対するモデルの適合度を評価してください。
モデル要約
| 逸脱 (deviance) R二乗 | 逸脱 (deviance) R二乗 (調整済み) | AIC | AICc(修正済み 赤池情報量基準) | BIC(ベイズ 情報量基準) |
|---|---|---|---|---|
| 97.95% | 76.75% | 105.98 | 171.98 | 114.48 |
主要な結果:逸脱度R二乗、逸脱度R二乗(調整済み)、AIC
これらの結果を基に、モデルは、応答変数における合計逸脱度のおよそ97.95%を説明づけます。これらのデータでは、逸脱度R2の値は、モデルがデータに十分に適合することを示しています。追加モデルが異なる予測変数と適合する場合、調整済み逸脱度R2の値、AICの値、AICcの値、BICの値を使用して、追加モデルがどの程度データに適合するかを比較します。
ステップ5:データに適合しないモデルかどうかを判断する
- 不適切なリンク関数
- モデル内にある変数の高次項が省略されています
- モデル内にはない予測変数が省略されています
- 過分散
逸脱度が統計的に有意な場合、別のリンク関数を実行、あるいはモデル内の項を変更できます。
- 逸脱度:逸脱度検定のp値では、1行当たりの試行回数が1回に配置されているデータの方が、試行回数が複数回のデータよりも低い傾向があり、一般的には、試行回数が少なくなるほどp値も減少します。データフォーマットが1試行/行の場合は、ホスマー-レメショウ検定の結果の信頼度がより高くなります。
- ピアソン:ピアソン検定で使用する近似カイ二乗分布は、データに含まれる行ごとの事象の期待数が小さい場合は不正確になります。それゆえ、データのフォーマットが1試行/行の場合、ピアソンの適合度検定は不正確となります。
- ホスマー-レメショウ(Hosmer-Lemeshow):ホスマー-レメショウ検定は他の適合度検定のように、データ内の行ごとの試行回数にも左右されません。データの各行の試行回数がほとんどない場合、ホスマー-レメショウ検定は、データに対するモデルの適合度を示す指標として、信頼度が高まります。
応答情報
| 変数 | 値 | 計数 | 事象名 |
|---|---|---|---|
| 損傷 | 事象 | 506 | Event |
| 非事象 | 7482 | ||
| コンテナ | 合計 | 7988 |
適合度検定
| 検定 | 自由度 | カイ二乗 | p値 |
|---|---|---|---|
| 逸脱 (deviance) | 5 | 0.97 | 0.965 |
| ピアソン | 5 | 0.97 | 0.965 |
| Hosmer-Lemeshow | 6 | 0.10 | 1.000 |
事象 試行フォーマットの主要な結果:応答情報、逸脱度検定、ピアソン検定、ホスマー-レメショウ検定
これらの結果では、すべての適合度検定のp値は、通常の有意水準である0.05よりも大きいです。この検定は、二項分布が予測できないように、予測される確率が観測される確率から離れた値になることを示す根拠にはなりません。
